빠른 시작
이 간단한 튜토리얼을 통해 1-2분 안에 Crawlee로 웹 스크래핑을 시작할 수 있습니다. Crawlee의 작동 방식을 자세히 알아보려면 첫 번째 스크래퍼를 만드는 포괄적인 단계별 가이드인 소개를 읽어보세요.
크롤러 선택하기
Crawlee는 세 가지 주요 크롤러 클래스를 제공합니다: CheerioCrawler, PuppeteerCrawler, PlaywrightCrawler. 모든 클래스는 동일한 인터페이스를 공유하여 크롤러 간 전환이 매우 유연합니다.
CheerioCrawler
기본 HTTP 크롤러입니다. Cheerio 라이브러리를 사용하여 HTML을 파싱하고, 브라우저처럼 동작하는 특수한 got-scraping HTTP 클라이언트를 사용합니다. 매우 빠르고 효율적이지만 JavaScript 렌더링은 처리할 수 없습니다.
PuppeteerCrawler
Puppeteer 라이브러리로 제어되는 헤드리스 브라우저를 사용하는 크롤러입니다. Chromium 또는 Chrome을 제어할 수 있으며, Puppeteer는 헤드리스 브라우저 자동화의 사실상 표준입니다.
PlaywrightCrawler
Playwright는 Puppeteer의 더 강력하고 기능이 풍부한 후속 버전입니다. Chromium, Chrome, Firefox, Webkit 등 다양한 브라우저를 제어할 수 있습니다. Puppeteer에 익숙하지 않고 헤드리스 브라우저가 필요하다면 Playwright를 선택하세요.
Crawlee는 Node.js 16 이상이 필요합니다.
Crawlee CLI를 통한 설치
Crawlee를 시작하는 가장 빠른 방법은 Crawlee CLI를 사용하고 시작하기 예제를 선택하는 것입니다. CLI가 필요한 모든 종속성을 설치하고 실험해볼 수 있는 기본 코드를 추가해 줍니다.
npx crawlee create my-crawler
설치가 완료되면 다음과 같이 크롤러를 시작할 수 있습니다:
cd my-crawler && npm start
수동 설치
다음 명령어를 실행하여 모든 Node.js 프로젝트에 Crawlee를 추가할 수 있습니다:
- CheerioCrawler
- PlaywrightCrawler
- PuppeteerCrawler
npm install crawlee
playwright is not bundled with Crawlee to reduce install size and allow greater flexibility. You need to explicitly install it with NPM. 👇
npm install crawlee playwright
puppeteer is not bundled with Crawlee to reduce install size and allow greater flexibility. You need to explicitly install it with NPM. 👇
npm install crawlee puppeteer
크롤링
다음 예제를 실행하여 선택한 크롤러를 사용해 Crawlee 웹사이트를 재귀적으로 크롤링할 수 있습니다.
예제를 실행하려면 package.json에 "type": "module" 구문을 추가하거나
.mjs 확장자를 가진 파일에 복사하세요. 이렇게 하면 Node.js에서 import 구문을 사용할 수 있습니다.
자세한 내용은 Node.js 문서를 참조하세요.
- CheerioCrawler
- PlaywrightCrawler
- PuppeteerCrawler
import { CheerioCrawler, Dataset } from 'crawlee';

// CheerioCrawler는 HTTP 요청을 사용하여 웹을 크롤링하고
// Cheerio 라이브러리를 사용하여 HTML을 파싱합니다.
const crawler = new CheerioCrawler({
    // requestHandler를 사용하여 크롤링된 각 페이지를 처리합니다.
    async requestHandler({ request, $, enqueueLinks, log }) {
        const title = $('title').text();
        log.info(`Title of ${request.loadedUrl} is '${title}'`);

        // 결과를 ./storage/datasets/default에 JSON으로 저장합니다
        await Dataset.pushData({ title, url: request.loadedUrl });

        // 현재 페이지에서 링크를 추출하여
        // 크롤링 대기열에 추가합니다.
        await enqueueLinks();
    },

    // 테스트를 더 안전하고 빠르게 실행하기 위해
    // 크롤링 요청 수를 제한하겠습니다.
    maxRequestsPerCrawl: 50,
});

// 첫 번째 URL을 대기열에 추가하고 크롤링을 시작합니다.
await crawler.run(['https://crawlee.dev']);
import { PlaywrightCrawler, Dataset } from 'crawlee';

// PlaywrightCrawler는 Playwright 라이브러리로 제어되는
// 헤드리스 브라우저를 사용하여 웹을 크롤링합니다.
const crawler = new PlaywrightCrawler({
    // requestHandler를 사용하여 크롤링된 각 페이지를 처리합니다.
    async requestHandler({ request, page, enqueueLinks, log }) {
        const title = await page.title();
        log.info(`Title of ${request.loadedUrl} is '${title}'`);

        // 결과를 ./storage/datasets/default에 JSON으로 저장합니다
        await Dataset.pushData({ title, url: request.loadedUrl });

        // 현재 페이지에서 링크를 추출하여
        // 크롤링 대기열에 추가합니다.
        await enqueueLinks();
    },
    // 브라우저 창을 보려면 이 옵션의 주석을 해제하세요.
    // headless: false,

    // 테스트를 더 안전하고 빠르게 실행하기 위해
    // 크롤링 요청 수를 제한하겠습니다.
    maxRequestsPerCrawl: 50,
});

// 첫 번째 URL을 대기열에 추가하고 크롤링을 시작합니다.
await crawler.run(['https://crawlee.dev']);
import { PuppeteerCrawler, Dataset } from 'crawlee';

// PuppeteerCrawler는 Puppeteer 라이브러리로 제어되는
// 헤드리스 브라우저를 사용하여 웹을 크롤링합니다.
const crawler = new PuppeteerCrawler({
    // requestHandler를 사용하여 크롤링된 각 페이지를 처리합니다.
    async requestHandler({ request, page, enqueueLinks, log }) {
        const title = await page.title();
        log.info(`Title of ${request.loadedUrl} is '${title}'`);

        // 결과를 ./storage/datasets/default에 JSON으로 저장합니다
        await Dataset.pushData({ title, url: request.loadedUrl });

        // 현재 페이지에서 링크를 추출하여
        // 크롤링 대기열에 추가합니다.
        await enqueueLinks();
    },
    // 브라우저 창을 보려면 이 옵션의 주석을 해제하세요.
    // headless: false,

    // 테스트를 더 안전하고 빠르게 실행하기 위해
    // 크롤링 요청 수를 제한하겠습니다.
    maxRequestsPerCrawl: 50,
});

// 첫 번째 URL을 대기열에 추가하고 크롤링을 시작합니다.
await crawler.run(['https://crawlee.dev']);
예제를 실행하면 터미널에서 Crawlee가 데이터를 추출하는 과정을 확인할 수 있습니다.
INFO  CheerioCrawler: Starting the crawl
INFO  CheerioCrawler: Title of https://crawlee.dev/ is 'Crawlee · Build reliable crawlers. Fast. | Crawlee'
INFO  CheerioCrawler: Title of https://crawlee.dev/docs/examples is 'Examples | Crawlee'
INFO  CheerioCrawler: Title of https://crawlee.dev/docs/quick-start is 'Quick Start | Crawlee'
INFO  CheerioCrawler: Title of https://crawlee.dev/docs/guides is 'Guides | Crawlee'
헤드풀 브라우저 실행하기
Puppeteer와 Playwright가 제어하는 브라우저는 기본적으로 헤드리스(화면 표시 없음)로 실행됩니다. 크롤러 생성자에 headless: false 옵션을 추가하여 헤드풀 모드로 전환할 수 있습니다. 이는 브라우저에서 어떤 일이 일어나는지 확인하고 싶은 개발 단계에서 유용합니다.
- PlaywrightCrawler
- PuppeteerCrawler
import { PlaywrightCrawler, Dataset } from 'crawlee';

const crawler = new PlaywrightCrawler({
    async requestHandler({ request, page, enqueueLinks, log }) {
        const title = await page.title();
        log.info(`Title of ${request.loadedUrl} is '${title}'`);
        await Dataset.pushData({ title, url: request.loadedUrl });
        await enqueueLinks();
    },
    // headless 모드를 끄면 크롤러가
    // 브라우저 창을 표시하며 실행됩니다.
    headless: false,

    // 테스트를 더 안전하고 빠르게 실행하기 위해
    // 크롤링 요청 수를 제한하겠습니다.
    maxRequestsPerCrawl: 50,
});

// 첫 번째 URL을 대기열에 추가하고 크롤링을 시작합니다.
await crawler.run(['https://crawlee.dev']);
import { PuppeteerCrawler, Dataset } from 'crawlee';

const crawler = new PuppeteerCrawler({
    async requestHandler({ request, page, enqueueLinks, log }) {
        const title = await page.title();
        log.info(`Title of ${request.loadedUrl} is '${title}'`);
        await Dataset.pushData({ title, url: request.loadedUrl });
        await enqueueLinks();
    },
    // headless 모드를 끄면 크롤러가
    // 브라우저 창을 표시하며 실행됩니다.
    headless: false,

    // 테스트를 더 안전하고 빠르게 실행하기 위해
    // 크롤링 요청 수를 제한하겠습니다.
    maxRequestsPerCrawl: 50,
});

// 첫 번째 URL을 대기열에 추가하고 크롤링을 시작합니다.
await crawler.run(['https://crawlee.dev']);
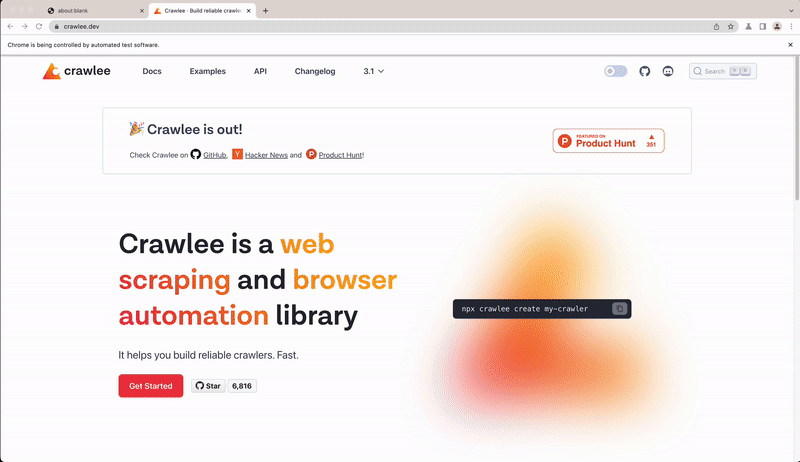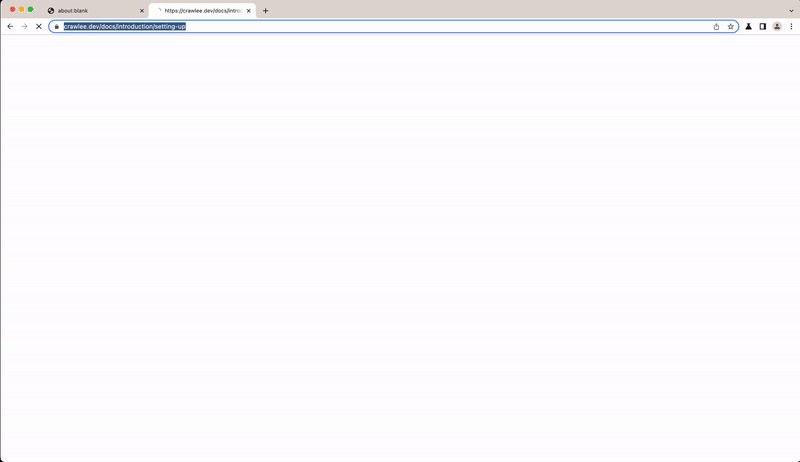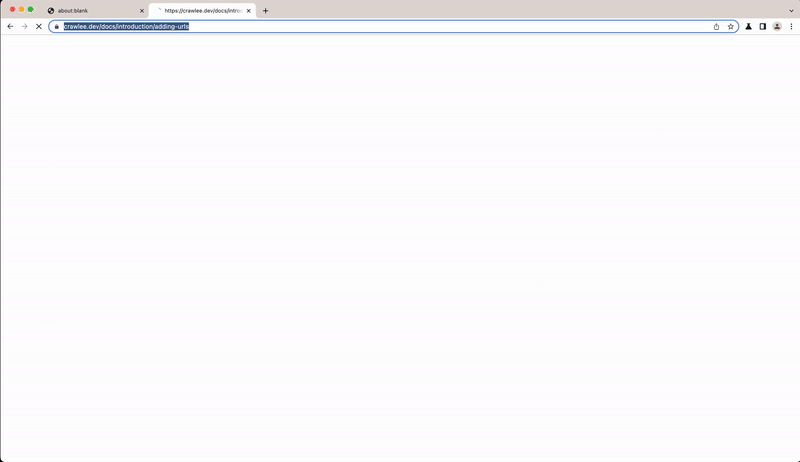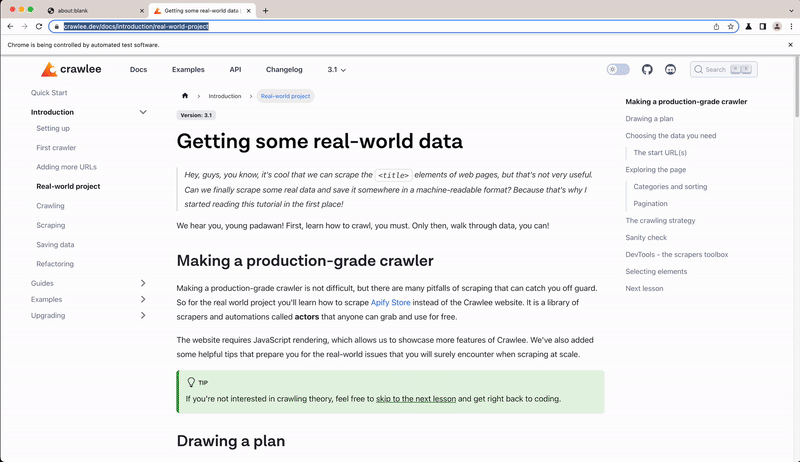
예제 코드를 실행하면 자동화된 브라우저가 Crawlee 웹사이트를 빠르게 탐색하는 것을 볼 수 있습니다.
이 데모를 위해 크롤러의 속도를 늦추었지만, 실제 사용에서는 매우 빠른 속도로 동작합니다.
Results
Crawlee는 현재 작업 디렉토리의 ./storage 폴더에 데이터를 저장합니다. 크롤링 결과는 ./storage/datasets/default/*.json 경로에 JSON 파일로 저장됩니다.
{
    "url": "https://crawlee.dev/",
    "title": "Crawlee · The scalable web crawling, scraping and automation library for JavaScript/Node.js | Crawlee"
}
CRAWLEE_STORAGE_DIR 환경 변수를 설정하여 저장소 디렉토리를 변경할 수 있습니다.
예제와 추가 자료
Crawlee의 다양한 기능을 보여주는 더 많은 예제는 문서의 예제 섹션에서 찾을 수 있습니다. Crawlee와 그 구성 요소를 더 잘 이해하려면 단계별 가이드인 소개를 읽어보세요.
관련 링크